/Architetture software/di Gianluca Epifani
Autotrasporti 2.0: integrazioni col senno di poi
Houston, we have a problem…
Un’azienda di autotrasporti, qualche decina di mezzi, clienti che vanno dalla grande distribuzione all’industria. I sistemi che ho trovato sono questi. Un gestionale con il modulo trasporti, che fa i viaggi, le anagrafiche e le fatture. Un fornitore di telematica che segue i mezzi e li espone con le sue API. Un’app per gli autisti, scritta anni prima da una software house locale, con cui si registrano ritiri e consegne e si fotografa la bolla firmata. Un portale su cui i clienti guardano le spedizioni e scaricano i documenti. Tre clienti grossi che mandano gli ordini via EDI e vogliono le notifiche “sul loro sistema”, gli altri che li mandano dal portale o per email. In mezzo, l’ufficio: due persone che pianificano i viaggi e una che fattura.
Quello che tutto questo deve fare è semplice da dire: prendere un ordine, riservare un mezzo e un giorno, prenotare lo scarico sul magazzino del cliente, eseguire il viaggio, provare la consegna con una bolla firmata, fatturarla, e tenere informato il cliente lungo tutto il percorso. Ogni pezzo, preso da solo, fa la sua parte.
Il problema è il modo in cui i pezzi si parlano. La settimana in cui mi hanno chiamato, il fornitore di telematica aveva avuto un guasto di tre ore e per tre ore il portale clienti aveva mostrato una pagina di errore, perché chiedeva la posizione dei mezzi in tempo reale a ogni apertura. La stessa settimana il cliente più grande aveva contestato una fattura con undici righe doppie: il batch notturno si era fermato a metà su un record strano, qualcuno l’aveva rilanciato la mattina dopo, e le consegne già importate erano state importate di nuovo. E il quarto cliente che chiedeva le notifiche sul suo sistema era in attesa da quattro mesi, perché le tre integrazioni precedenti erano state scritte dentro il gestionale e nessuno voleva toccarle di nuovo.
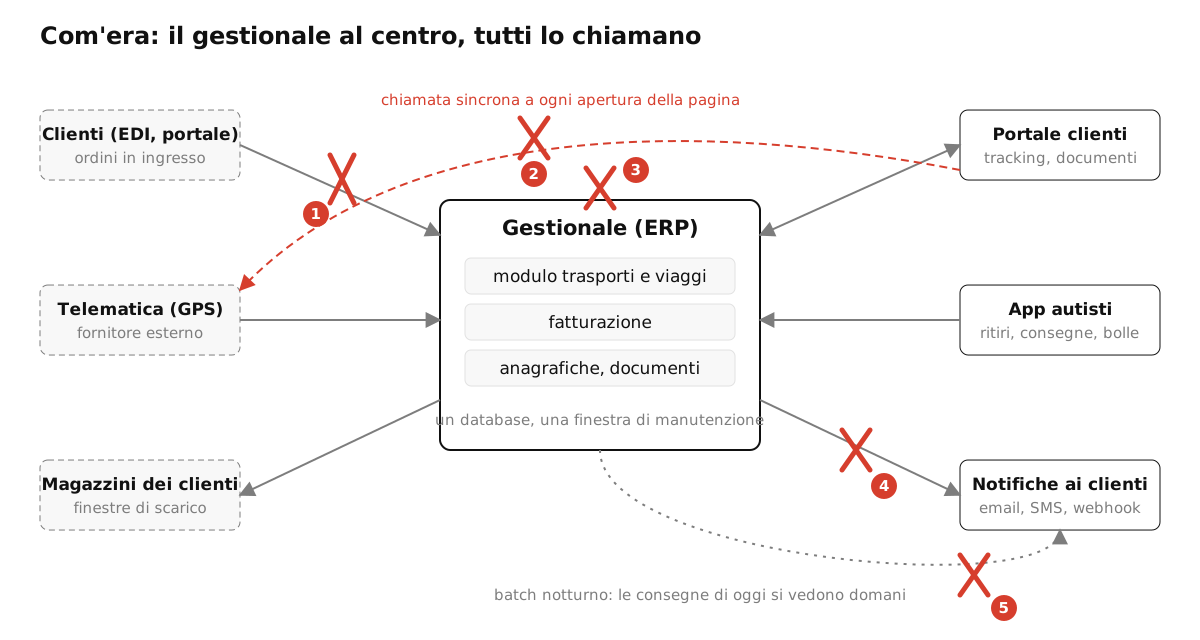
Nessuno aveva disegnato questo schema: era venuto così. Il gestionale c’era per primo, e ogni sistema arrivato dopo si era collegato a lui perché era l’unico posto dove stavano i dati. Le cinque X sono i cinque punti in cui, nel giro di un mese, avevo visto rompersi qualcosa.
- Gli ordini EDI entrano direttamente nel gestionale. Quando il gestionale è in manutenzione, o la sua base dati è occupata dalla fatturazione di fine mese, l’ordine del cliente non viene preso. Il cliente non lo rispedisce: dal suo punto di vista lo ha mandato.
- Il portale chiama il fornitore di telematica a ogni apertura della pagina. Un cliente apre il tracking, il portale chiede la posizione del mezzo al fornitore GPS, in tempo reale. Quando il fornitore è lento, il portale è lento; quando è giù, il portale è giù. E il fornitore fattura a chiamata.
- Il gestionale è il collo di bottiglia di tutto. Non è stato fatto per ricevere posizioni GPS ogni trenta secondi da decine di mezzi né per rispondere al portale; lo fa, ma ogni nuovo carico lo rallenta e ogni suo rallentamento si vede dappertutto.
- Ogni cliente che vuole le notifiche sul suo sistema è un progetto. Il primo ha voluto un’email, il secondo un file su FTP, il terzo una chiamata al suo software. Tre integrazioni scritte dentro il gestionale, tre cose che si rompono quando cambia qualcosa, e il quarto cliente aspetta.
- La fatturazione gira la notte. Le consegne di oggi diventano righe domani mattina, se il batch non si è fermato su un record strano. Quando si ferma, qualcuno lo rilancia a mano, e le consegne già importate entrano una seconda volta: righe doppie, note di credito, un cliente che ha ragione a lamentarsi. Il cliente vede la consegna il giorno dopo, l’ufficio scopre i problemi a fine mese.
Nessuno di questi difetti era un errore di chi li aveva fatti. Erano la conseguenza di una regola non scritta: “quando serve un dato, chiama chi ce l’ha”. Finché i sistemi erano due, funzionava. Al quinto, ogni sistema dipendeva dalla disponibilità di tutti gli altri, e il più fragile dettava la disponibilità dell’insieme.
Architettura 2.0: facciamo ordine
La prima cosa che ho detto è che il gestionale non si butta. Fa le fatture, custodisce le anagrafiche, lo conosce l’ufficio amministrativo. Quello che ho proposto di cambiare è la regola: nessuno chiama più nessuno in tempo reale. Ogni fatto che succede nell’azienda viene scritto una volta sola su un bus di eventi, e chiunque ne abbia bisogno lo legge da lì, quando può.
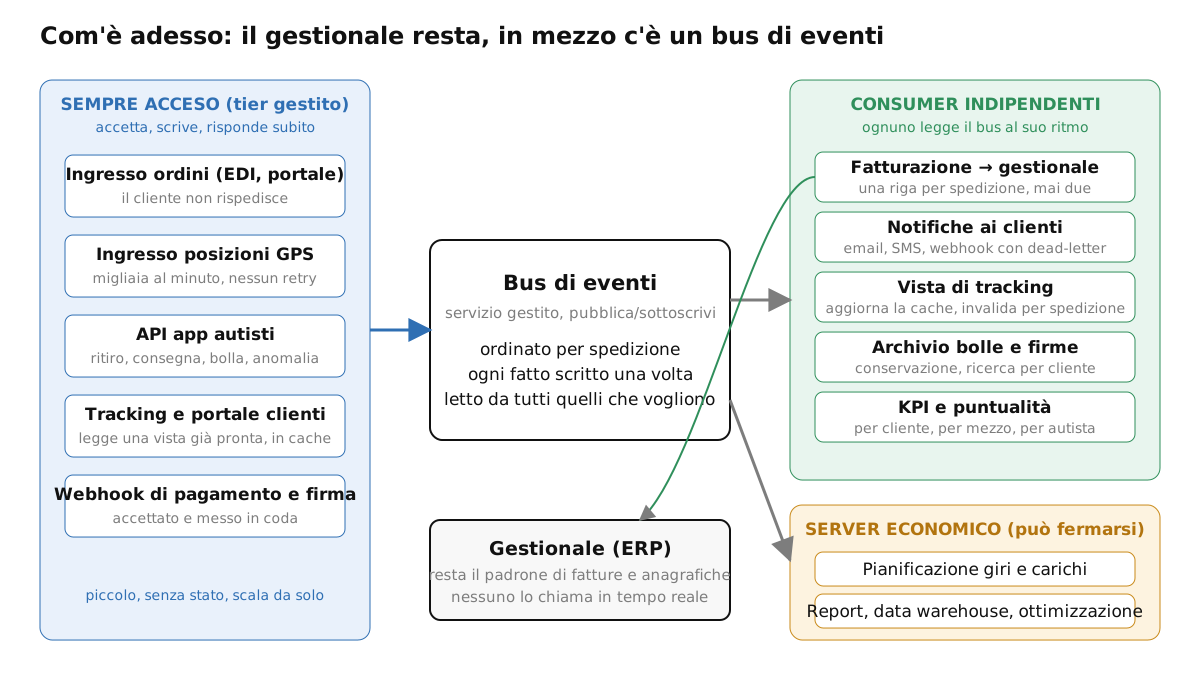
I fatti sono pochi e tutti del mestiere: ordine ricevuto, capacità riservata, mezzo assegnato, ritiro effettuato, posizione, consegna effettuata (con bolla e firma), anomalia (danno, rifiuto, ritardo), fattura emessa. Ognuno porta con sé l’identificativo della spedizione, e il bus garantisce che gli eventi di una stessa spedizione vengano letti nell’ordine in cui sono stati scritti: il ritiro prima della consegna, sempre. Spedizioni diverse viaggiano in parallelo.
Chi legge sono i consumer, servizi piccoli e indipendenti, uno per compito. La fatturazione legge le consegne e scrive la riga nel gestionale. Le notifiche leggono tutto e avvisano i clienti nel modo che ciascuno ha scelto. Il tracking aggiorna una vista già pronta che il portale si limita a mostrare. L’archivio conserva le bolle firmate. I KPI contano la puntualità per cliente, per mezzo, per autista. Se le notifiche sono ferme per un’ora, la fatturazione non se ne accorge; quando ripartono, leggono l’ora di eventi arretrati e si mettono in pari.
La frase che riassume il cambio è questa: l’accoppiamento fra due sistemi è un dato in una tabella, non una chiamata nel codice. Il quarto cliente che vuole le notifiche sul suo sistema non è più un progetto: è un consumer in più, o una riga di configurazione in quello che c’è già, e non tocca né il gestionale né gli altri.
La terza zona del disegno è quella che si vede meno e vale di più. Alcune cose arrivano da fuori e non si ripetono: gli ordini EDI, le posizioni dei mezzi, i webhook del fornitore di firma digitale. Chi li manda non ritenta, quindi chi li riceve deve essere sempre acceso. Ma “sempre acceso” costa, e la tentazione è metterci tutto. Il senno di poi dice il contrario: il servizio sempre acceso deve essere minuscolo, senza stato, con un compito solo, accettare la richiesta, scriverla sul bus, rispondere. Tutto il resto, la pianificazione dei giri, i report, l’ottimizzazione dei carichi, può girare su un server economico che si ferma mezz’ora senza che nessuno perda un dato. Separare le due cose è la decisione di architettura che vale più soldi di tutte le altre messe insieme.
Il viaggio di una consegna
Seguiamo un evento solo, dal telefono dell’autista alla fattura, perché è lì che si vede la differenza con il punto 5 dello schema con le X.
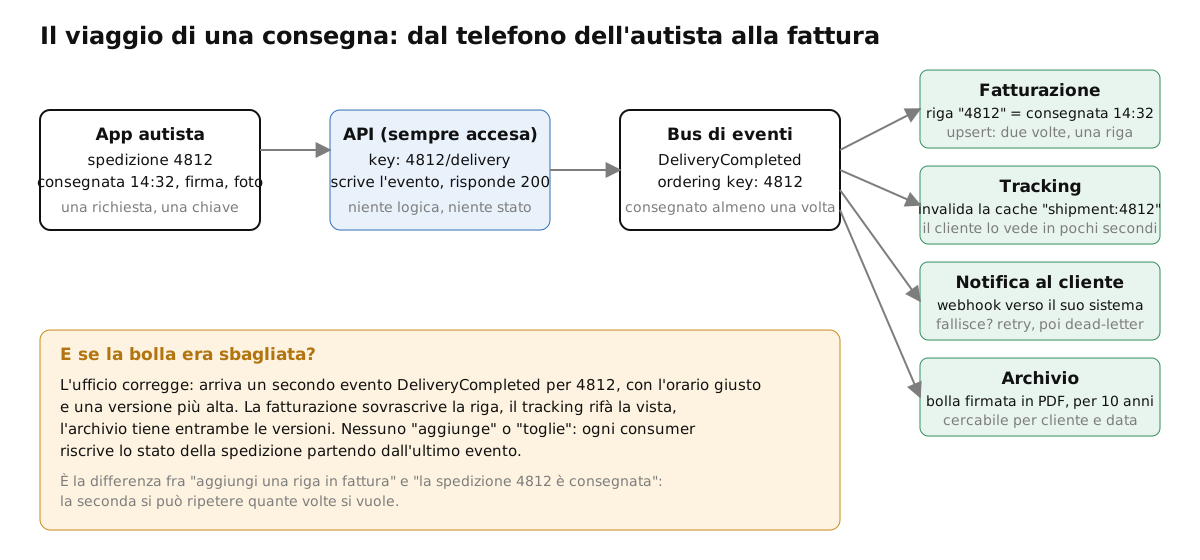
L’autista preme “consegnato” alle 14:32, allega la firma e una foto. L’app manda una richiesta che porta una chiave: spedizione 4812, evento consegna. L’API, che sta nella zona sempre accesa, scrive l’evento sul bus e risponde. Da qui in poi l’evento può arrivare ai consumer più di una volta, ed è normale: il bus lo consegna almeno una volta, quindi se un consumer cade dopo averlo letto e prima di confermarlo, lo riceve di nuovo al riavvio; e l’ufficio può correggere la bolla, emettendo lo stesso evento con una versione più alta. Un sistema che importa due volte la stessa consegna, come faceva il batch, qui non è ammesso per costruzione.
// The envelope every event carries on the bus. The idempotency key is
// chosen by whoever produces the fact (the app), not by the receiver.
type Event struct {
    Type       string          `json:"type"`        // "delivery_completed"
    ShipmentID string          `json:"shipment_id"` // ordering key
    Key        string          `json:"key"`         // "4812/delivery"
    Version    int             `json:"version"`     // bumped on every correction
    OccurredAt time.Time       `json:"occurred_at"`
    Payload    json.RawMessage `json:"payload"`
}

func (a *API) delivery(w http.ResponseWriter, r *http.Request) {
    var ev Event
    if err := json.NewDecoder(r.Body).Decode(&ev); err != nil {
        http.Error(w, "bad request", http.StatusBadRequest)
        return
    }
    // Publish with the shipment as ordering key. The bus deduplicates
    // on the key for a time window; beyond that, consumers take over.
    if err := a.bus.Publish(r.Context(), ev.ShipmentID, ev); err != nil {
        http.Error(w, "retry later", http.StatusServiceUnavailable)
        return
    }
    w.WriteHeader(http.StatusAccepted)
}
Quello della fatturazione, quindi, non “aggiunge una riga”: scrive che la spedizione 4812 è stata consegnata alle 14:32, e lo scrive con un’istruzione che se la riga c’è già la sovrascrive, e se la versione che ha è più nuova di quella che arriva non fa niente.
INSERT INTO invoice_lines (shipment_id, delivered_at, version, amount)
VALUES ($1, $2, $3, $4)
ON CONFLICT (shipment_id) DO UPDATE
   SET delivered_at = EXCLUDED.delivered_at,
       amount       = EXCLUDED.amount,
       version      = EXCLUDED.version
 WHERE invoice_lines.version < EXCLUDED.version;
Questa istruzione è il cuore di tutto il post. La si può eseguire due volte, dieci volte, in ordine sbagliato dopo un riavvio: il risultato è sempre una riga per spedizione, con l’ultima versione. Ed è anche il modo in cui l’ufficio corregge una bolla sbagliata: non entra nel gestionale a modificare la riga a mano, emette un nuovo evento di consegna con la versione due, e tutti i consumer, fatturazione, tracking, archivio, si aggiornano da soli e nello stesso modo. Prima una correzione era una telefonata e tre sistemi da toccare.
Chi sviluppa chiama questa proprietà idempotenza. Chi gestisce l’azienda la riconosce da un altro sintomo: le note di credito di fine mese spariscono.
La presa in carico di un ordine
Non tutto è un fatto singolo. Prendere in carico un ordine è una procedura: bisogna riservare un mezzo e un giorno, prenotare una finestra di scarico sul magazzino del cliente, che ha il suo sistema e i suoi orari, e solo allora confermare. Prima era una chiamata che dentro ne faceva un’altra che dentro ne faceva un’altra; se la terza falliva, la prima aveva già scritto, e qualcuno in ufficio si accorgeva il giorno dopo di un mezzo riservato per un viaggio mai confermato.
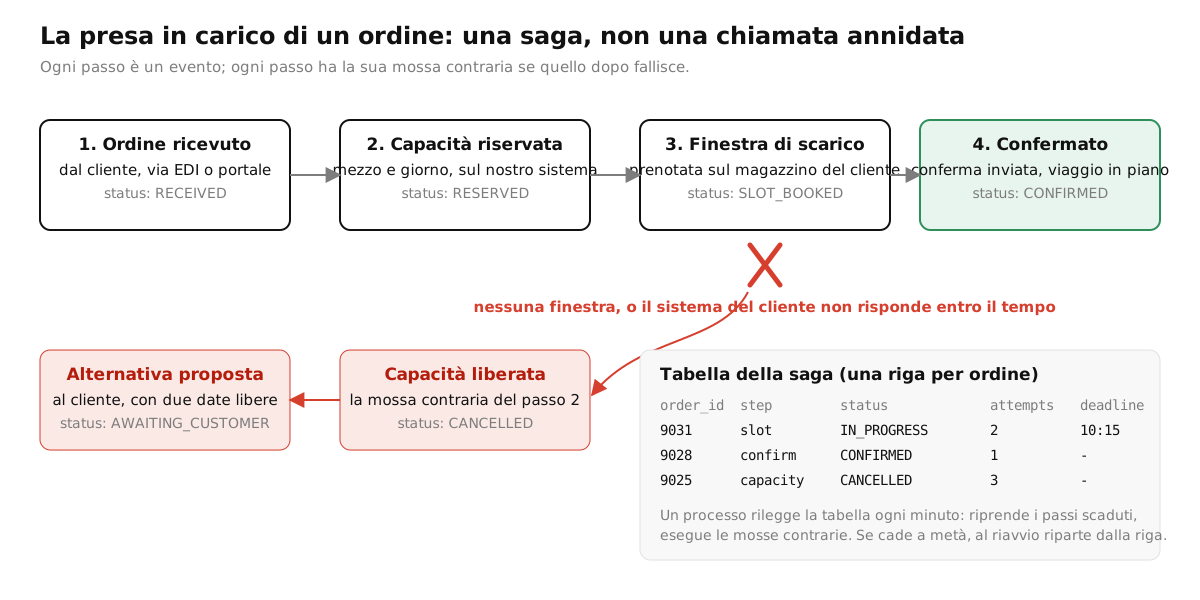
Il nome del pattern è saga: una sequenza di passi, ognuno dei quali è un evento, e per ogni passo una mossa contraria da eseguire se uno dei passi successivi fallisce. Lo stato di ogni ordine sta in una tabella, una riga per ordine, con il passo in corso, i tentativi fatti e una scadenza. Un processo rilegge quella tabella ogni minuto: fa avanzare gli ordini che possono avanzare, ritenta i passi scaduti, e quando un passo fallisce definitivamente esegue le mosse contrarie di quelli prima. Se il processo cade a metà, al riavvio riparte dalla riga, perché la riga è tutto ciò che sa.
// One saga step: what to do, and how to undo it.
type Step struct {
    Name       string
    Execute    func(ctx context.Context, o *Order) error
    Compensate func(ctx context.Context, o *Order) error
}

var orderIntake = []Step{
    {"capacity", reserveCapacity, releaseCapacity},
    {"slot", bookUnloadingSlot, cancelUnloadingSlot},
    {"confirm", confirmToCustomer, nil}, // the last step is never undone
}

func (s *Saga) advance(ctx context.Context, o *Order) error {
    for i := o.CurrentStep; i < len(orderIntake); i++ {
        if err := orderIntake[i].Execute(ctx, o); err != nil {
            if !errors.Is(err, ErrPermanent) {
                return s.retryLater(ctx, o, err) // deadline, attempts+1
            }
            for j := i - 1; j >= 0; j-- { // compensate, backwards
                if c := orderIntake[j].Compensate; c != nil {
                    if err := c(ctx, o); err != nil {
                        return s.retryLater(ctx, o, err)
                    }
                }
            }
            return s.close(ctx, o, "awaiting_customer")
        }
        o.CurrentStep = i + 1
        if err := s.save(ctx, o); err != nil { // persist the row after each step
            return err
        }
    }
    return s.close(ctx, o, "confirmed")
}
Il magazzino del cliente che non risponde non blocca più nulla: l’ordine resta nella tabella con una scadenza, il processo ritenta, e se dopo un’ora non c’è una finestra libera la capacità torna disponibile e il cliente riceve due date alternative. Tutto questo senza che nessuno in ufficio debba accorgersene, e con una tabella che si può aprire per vedere, in ogni momento, dove sta ogni ordine. Prima quella tabella era la memoria del commerciale.
Notifiche, tracking e le cose che falliscono piano
Due consumer meritano una parola in più, perché sono quelli che nel sistema vecchio davano più fastidio.
Le notifiche verso i sistemi dei clienti falliscono di continuo, e non per colpa nostra: il software del cliente è giù, il certificato è scaduto, l’indirizzo è cambiato e nessuno l’ha detto. Il consumer ritenta con attese crescenti e, dopo un certo numero di tentativi, sposta l’evento in una coda di scarto, la dead-letter, dove qualcuno in ufficio lo vede, chiama il cliente, e lo rimette in coda quando il problema è risolto. Nessun evento va perso e nessun fallimento di un cliente rallenta gli altri. Il punto 4 dello schema con le X diventa una configurazione per cliente: canale, indirizzo, formato.
Il tracking è il contrario: non fallisce, ma viene aperto tante volte, dalla stessa persona, nella stessa ora. La pagina del portale legge una vista già pronta della spedizione, tenuta in cache a due livelli, in memoria nel servizio e in una cache distribuita condivisa. Quando arriva un evento della spedizione 4812, il consumer del tracking invalida la voce “shipment:4812” e la rigenera; tutte le altre restano valide. Il fornitore di telematica viene letto una volta ogni trenta secondi per mezzo, dal consumer, non dal portale a ogni clic: il punto 2 dello schema con le X sparisce, e con lui la fattura a chiamata.
Come si prova senza paura
Un’architettura così si prova meglio di quella che c’era, ed è una cosa che chi deve approvarla vuole sentirsi dire. Ogni consumer è un programma piccolo con un ingresso, gli eventi, e un’uscita, una tabella o una chiamata. Nei test il gestionale, il fornitore GPS e il sistema del magazzino del cliente sono server HTTP finti che rispondono quello che decidiamo noi, compresi i casi brutti: timeout, errore a metà, risposta duplicata. La base dati è un Postgres vero, avviato per i test, perché l’istruzione di upsert di cui sopra va provata sul database, non su un’imitazione. La saga si prova facendo fallire ogni passo, uno alla volta, e controllando che le mosse contrarie lascino il sistema come lo avevano trovato.
Questo cambia anche il modo in cui si va in produzione. Non c’è stato un giorno dello switch: un consumer alla volta, acceso in lettura accanto al sistema vecchio, con i risultati confrontati per qualche settimana prima di spegnere il pezzo vecchio. La fatturazione a eventi è andata per un mese in parallelo al batch notturno, scrivendo in una tabella di confronto; quando le due hanno coinciso per trenta giorni di fila, il batch è stato spento.
Se il carico è a temperatura controllata
Questa azienda trasporta pallet. Se trasportasse farmaci, o qualunque cosa a temperatura controllata, il disegno sarebbe lo stesso con un evento in più e un consumer in più. L’evento è la temperatura, letta dai sensori del vano di carico e scritta sul bus con la spedizione come chiave, accanto alla posizione. Il consumer è quello che conosce i limiti di ogni lotto e, quando legge un’escursione, blocca il lotto, apre la non conformità e avvisa chi di dovere, prima che il mezzo arrivi. Il richiamo di un lotto, che con il disegno vecchio è una settimana di telefonate e fogli di calcolo, diventa una domanda al bus: tutte le spedizioni che hanno contenuto quel lotto, con la storia completa di temperatura e consegna, già archiviata per ciascuna. La tracciabilità che le norme chiedono non si aggiunge dopo: è la forma naturale di un sistema in cui ogni fatto è un evento conservato.
Concludo
Col senno di poi, quell’azienda non aveva bisogno di tecnologia nuova. Aveva bisogno di una regola nuova sul modo in cui i suoi sistemi si parlano, e di qualcuno che la facesse rispettare per i primi mesi, finché non è diventata l’abitudine della casa. Il gestionale è rimasto il gestionale; il fornitore di telematica è rimasto lo stesso; l’app degli autisti è stata toccata in un punto solo, l’indirizzo a cui manda le consegne. Quello che è cambiato sta in mezzo, e si vede dai sintomi che spariscono: il portale che non cade più quando cade qualcun altro, le note di credito di fine mese, il cliente nuovo che chiede le notifiche sul suo sistema e le ha la settimana dopo.
Gli strumenti, per chi vuole i nomi, sono questi. Niente di esotico: i mattoni che qualunque sviluppatore sa usare, messi nell’ordine giusto.
Pub/Sub su Google Cloud, con chiavi di ordinamento e dead-letter incluse; SQS FIFO con SNS se usate AWS; Service Bus su Azure. Kafka solo se avete chi lo amministra.
Un servizio serverless a consumo: Cloud Run, Lambda dietro API Gateway, oppure Cloudflare Workers. Codice in Go: parte in pochi millisecondi e costa zero quando non arriva nulla.
Lo stesso servizio serverless, uno per sottoscrizione; oppure un piccolo cluster Kubernetes gestito (GKE, EKS) se ne avete già uno.
Postgres gestito: Cloud SQL, RDS se usate AWS, oppure Neon. Stessa base dati per la tabella della saga e le righe di fattura.
Redis gestito: Memorystore, ElastiCache o Upstash. Il primo livello è la memoria del servizio.
Una macchina dedicata da Hetzner o OVH per pianificazione e report: costa quanto una cena al mese e può restare spenta la notte.
GitHub con le Actions: test a ogni pull request, deploy a ogni merge.
OpenTelemetry con Grafana Cloud, che all'inizio basta nel piano gratuito.