/Architetture software/di Gianluca Epifani
Cloud o server dedicato?
Cosa ho trovato
Un grande marketplace, milioni di prodotti, una vetrina per nazione. Il mio cliente è il team che ne cura la pubblicità su Google Shopping, e il sistema che gestisce questo lavoro è il protagonista del post.
Il sistema che ho trovato faceva tutto questo in cloud, e lo faceva bene: un database Postgres gestito con la sua replica, un cluster Kubernetes gestito con i servizi dell’applicazione, bilanciatori, NAT, storage, log. Intorno ai mille euro al mese, e la cifra cresceva con ogni nazione aggiunta e con ogni milione di prodotti in più, perché dischi, memoria e operazioni di I/O si pagano a consumo. Il primo problema era questo: si pagava la disponibilità garantita di tutto, mentre a servire sempre erano due chiamate soltanto.
Il secondo problema era il database. I prodotti si aggiornano di continuo, perché i prezzi cambiano e Google scarta le offerte che non corrispondono più alla scheda: il sistema rileggeva il catalogo a pezzi tutto il giorno e lo riscriveva, e il primo del mese lo riscriveva per intero. Nello stesso momento arrivavano i click, e per rimandare chi clicca alla scheda giusta l’applicazione cercava il prodotto nel database, perché l’identificativo nel link era una chiave interna che da sola non diceva nulla. Con il database impegnato dalle scritture, quella lettura impiegava a volte secondi: la persona aspettava davanti a una pagina bianca, e il click era pagato comunque.
Il terzo problema stava nelle chiavi. I prodotti avevano un UUID generato a caso come chiave primaria, e con milioni di righe un indice su valori casuali è la cosa peggiore che si possa chiedere a un database che scrive tanto: ogni inserimento cade in un punto diverso dell’albero, le pagine dell’indice non stanno in memoria, e ogni lettura per chiave è un salto in un punto a caso del disco. Lo stesso UUID viaggiava verso Google come identificativo dell’offerta e tornava indietro nei click e negli ordini, illeggibile e inutile senza una lettura.
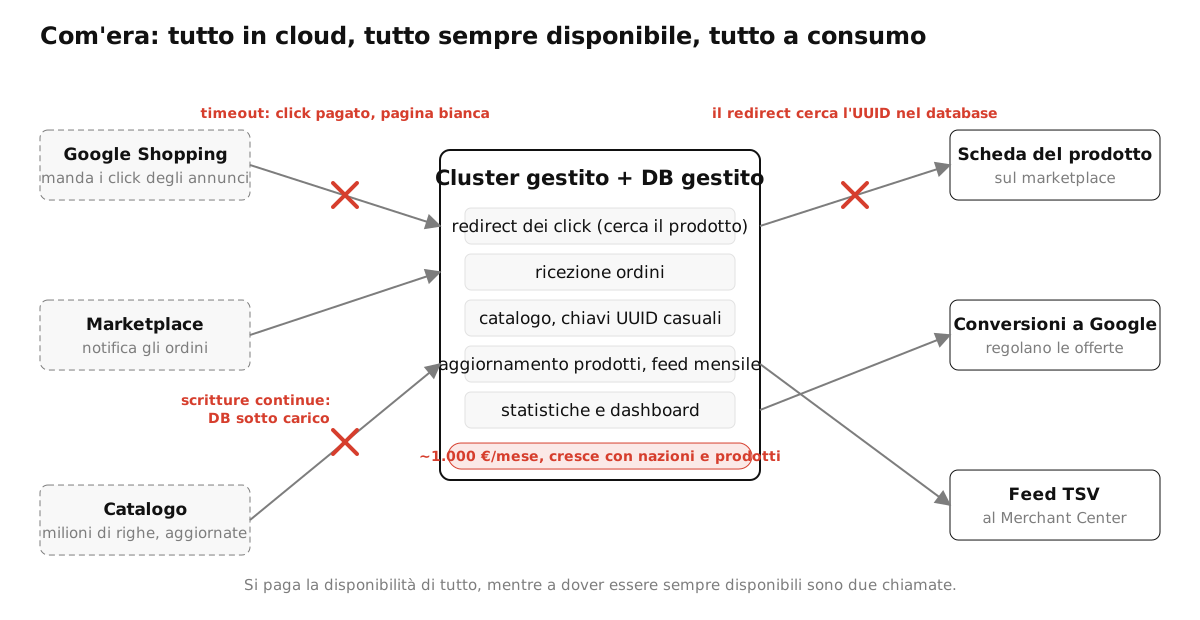
I tre problemi avevano la stessa radice. Le due chiamate che arrivano da fuori, il click e l’ordine, erano appese alla disponibilità di un database che per sua natura doveva essere occupato per ore, e per tenerle al sicuro si comprava la disponibilità di tutto il resto. Non era un problema di potenza: era un problema di cosa stava insieme a cosa.
Ripensiamo l’architettura
La domanda che ho fatto per ogni pezzo non è stata “quanto è importante?”, ma “se questa chiamata fallisce, si può rifare?”. Le risposte dividono il sistema in due.
Il click di Google e la notifica dell’ordine non si possono rifare: arrivano una volta, chi le manda non ritenta, e una chiamata persa è persa per sempre. Questi due sono il percorso critico e devono stare sempre online. Tutto il resto si può rifare: la generazione dei feed si rilancia, l’aggiornamento dei prodotti riprende da dove si era fermato, le statistiche si ricalcolano, e perfino l’indirizzo da cui Google viene a prendersi le conversioni non è critico, perché Google chiede “le conversioni delle ultime due ore” ogni ora e “quelle delle ultime ventiquattro” una volta al giorno: una lettura fallita viene ricoperta da quella dopo, e i doppioni li elimina Google sul numero d’ordine.
Da qui il disegno nuovo, in tre mosse. Il percorso critico, due indirizzi, va su un servizio serverless gestito: un container Go che accetta la chiamata, la scrive su una coda gestita, e risponde. Non ha database, non sa cosa sia un prodotto, a regime sta dentro il piano gratuito del fornitore, e quando il traffico raddoppia scala da solo. Il calcolo, cioè il catalogo da milioni di righe per nazione, gli aggiornamenti continui, i feed, le statistiche, la dashboard, va su un server dedicato: una macchina fisica con molta memoria e dischi NVMe, a prezzo fisso, con un piccolo cluster Kubernetes a nodo singolo, k3s, che coordina i servizi, e Postgres installato sull’host con un database per nazione. Fra i due c’è la coda, che conserva i messaggi per trentun giorni finché il server non li legge. E gli identificativi si rifanno: quello del prodotto diventa “intelligente”, cioè composto di cose che significano qualcosa fuori dal sistema, e le chiavi interne generate dal sistema diventano bigserial o uuidv7, che crescono nel tempo e si inseriscono in fondo all’indice invece di sparpagliarlo.
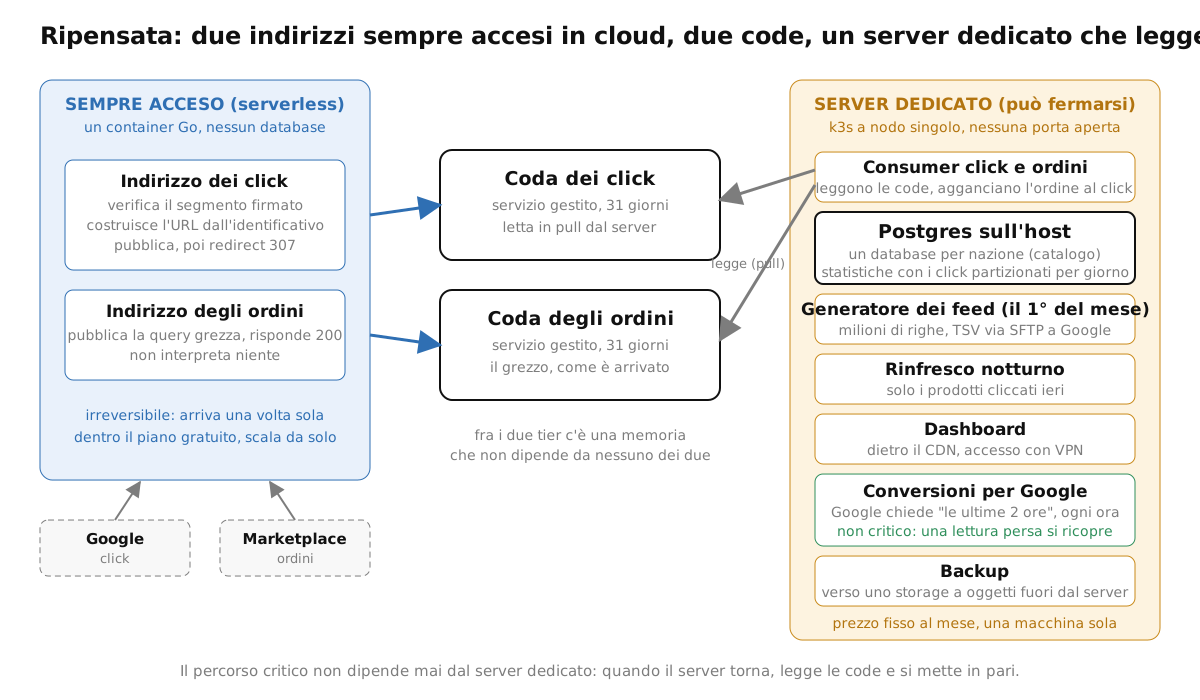
La regola che tiene insieme il disegno è che il percorso critico non dipende mai dal server dedicato, in nessuna direzione. Il server può essere spento per un aggiornamento, per un disco da cambiare, per un errore mio, e i click continuano a essere rimandati alla scheda giusta e gli ordini continuano a essere accettati. Quando torna, legge la coda e si mette in pari. Ma perché questo sia vero, l’indirizzo dei click deve saper rimandare alla scheda giusta senza chiedere nulla a nessuno. Ed è qui che il lavoro vero non è stato sull’infrastruttura, ma su un identificativo.
L’identificativo che contiene l’indirizzo
Nel sistema vecchio il link nel feed portava l’UUID del prodotto, e per sapere dove rimandare chi cliccava serviva una lettura: chiave, riga, URL della scheda. Il nuovo identificativo è composto, ed è composto di cose che servono fuori dal sistema.
shop-it-1005001234567
│    │  └── the product number on the marketplace, as it appears in its URLs
│    └───── the country: tells which storefront, and which database
└────────── the catalogue the product comes from
Con questo identificativo e nient’altro si costruisce l’indirizzo della scheda: la vetrina della nazione è nota, il numero del prodotto è dentro, e la forma dell’URL del marketplace è stabile. Lo stesso identificativo è l’offer_id che diamo a Google nel feed, quello che Google ci rimanda nei parametri del click, e quello che il marketplace ci rimanda nella notifica dell’ordine. Un identificativo che esce dal sistema deve dire da solo di cosa parla: un UUID costringeva a una lettura ogni volta che tornava indietro, e su Google era illeggibile per chi guarda i rapporti.
// A product id is composed of things that mean something outside the system.
// It is built and parsed only here: nobody else splits on "-".
type ProductID struct {
    Source  string // "shop"
    Country string // "it"
    SKU     string // "1005001234567" (may itself contain dashes)
}

func ParseID(s string) (ProductID, error) {
    parts := strings.SplitN(s, "-", 3) // three pieces, not every dash
    if len(parts) != 3 || parts[0] == "" || len(parts[1]) != 2 || parts[2] == "" {
        return ProductID{}, ErrBadID
    }
    return ProductID{Source: parts[0], Country: parts[1], SKU: parts[2]}, nil
}

// ProductURL needs no database: the storefront pattern per source is
// configuration, and the sku is the path.
func (id ProductID) ProductURL() string {
    pattern := storefronts[id.Source] // "https://%s.marketplace.example/item/%s.html"
    return fmt.Sprintf(pattern, id.Country, id.SKU)
}
Una scelta così ha un prezzo, e va detto prima di farla: il prefisso della sorgente diventa immutabile dal momento in cui esiste un prodotto, perché quegli identificativi sono già usciti verso Google e torneranno negli ordini per settimane. Nel nostro codice lo slug della sorgente si può correggere finché non ha prodotti, e poi si blocca. È una regola scritta nel database, non un’abitudine.
Le chiavi che restano interne seguono un’altra regola, più semplice: devono crescere nel tempo. Dove una tabella ha bisogno di una chiave generata dal sistema, è un bigserial se non esce mai di lì, o un uuidv7 se deve essere coniato fuori dal database, come il click id, che nasce sul servizio sempre acceso. In entrambi i casi un inserimento cade in fondo all’indice e le pagine calde restano in memoria; e un uuidv7 porta dentro l’istante in cui è nato, quindi quando un ordine arriva con il suo click id si sa già in quale partizione cercare. Con un UUID casuale su milioni di righe, l’indice era il collo di bottiglia prima ancora del disco.
Lo stesso principio del “basta leggerlo” vale per il parametro che identifica l’account pubblicitario nell’URL del click. Anche quello il servizio sempre acceso non può cercarlo in una tabella, perché la tabella sta sul server dedicato. Quindi è firmato: contiene l’identificativo dell’account e una firma HMAC con una chiave che il servizio conosce. Si verifica, non si cerca. E un segmento indovinato non passa, che è l’altra metà del motivo.
La vita di un click
Seguiamo un click dall’annuncio all’ordine, perché è il percorso su cui tutto il disegno si regge.
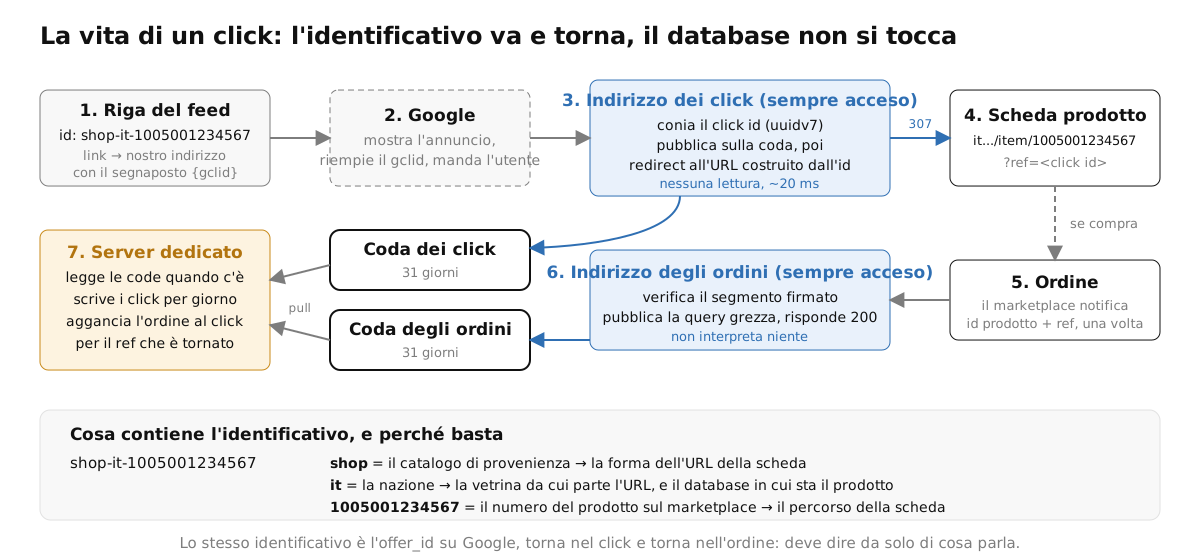
Nel feed ogni riga porta l’identificativo del prodotto e, come indirizzo di destinazione, un link verso il nostro servizio, con un segnaposto che Google riempie con il suo identificativo del click, il gclid. Quando una persona clicca, Google la manda a quel link. Il servizio sempre acceso fa tre cose nell’ordine giusto: conia un identificativo del click, pubblica sulla coda un messaggio con l’identificativo del prodotto, il gclid, l’account e l’ora, e risponde con un redirect verso la scheda del prodotto costruita dall’identificativo, con il click id accodato come parametro di tracciamento. Il marketplace conserva quel parametro e, se arriva un ordine, lo rimette nella notifica. È il filo che lega l’ordine al click.
func (r *Receiver) click(w http.ResponseWriter, req *http.Request) {
    acct, ok := r.verifyAccount(req.PathValue("token")) // HMAC, no lookup
    if !ok {
        http.Error(w, "not found", http.StatusNotFound)
        return
    }
    id, err := ParseID(req.URL.Query().Get("product_id"))
    if err != nil {
        http.Error(w, "bad request", http.StatusBadRequest)
        return
    }
    clickID := uuid.Must(uuid.NewV7()) // carries its own timestamp
    msg := ClickMessage{
        Account: acct, ClickID: clickID, ProductID: id.String(),
        GCLID: req.URL.Query().Get("gclid"), ReceivedAt: time.Now().UTC(),
        RemoteIP: clientIP(req), UserAgent: req.UserAgent(),
    }
    // Publish BEFORE redirecting: on a serverless container, work started
    // after the response may never get CPU time. A publish costs ~20 ms.
    if err := r.clicks.Publish(req.Context(), msg); err != nil {
        r.log.Error("publish failed", "err", err) // still redirect: the user comes first
    }
    dest := withParam(id.ProductURL(), "ref", clickID.String())
    http.Redirect(w, req, dest, http.StatusTemporaryRedirect)
}
Due dettagli di questo handler sono costati più di quanto sembri. Il primo è l’ordine: si pubblica prima e si risponde dopo. Il riflesso sarebbe il contrario, per non far aspettare l’utente; ma su un servizio serverless la CPU fuori dalla richiesta viene strozzata e un lavoro avviato dopo la risposta può non finire mai. Con una pubblicazione da venti millisecondi il compromesso non esiste, e questo è l’argomento più forte a favore della coda: non che sia veloce, ma che sia abbastanza veloce da non obbligare a scegliere fra sicurezza e velocità. Il secondo è che il redirect si fa comunque, anche se la pubblicazione fallisce: il click è pagato e la persona sta aspettando. Un click non si butta via per un nostro errore.
L’indirizzo degli ordini è ancora più semplice: verifica il segmento firmato, pubblica la query string grezza sulla coda degli ordini, risponde. Non la interpreta, perché l’interpretazione è un mestiere che cambia, e il grezzo è l’unica difesa il giorno che il marketplace cambia la forma di quello che manda.
Il server dedicato fa tutto il resto
Sul server i consumer leggono le due code e scrivono in un database di statistiche, separato dal catalogo: una tabella dei click partizionata per giorno, con il click id, il gclid, l’identificativo del prodotto e l’account; una tabella degli ordini, in cui il consumer cerca il click con il parametro di tracciamento tornato nella notifica e lo aggancia. Un ordine senza click si registra lo stesso, con il motivo: il click può essere più vecchio della finestra, o tracciato da un sistema precedente. Le domande che valgono soldi, quanto passa da un click a una conversione, quale prodotto converte, in quale nazione, si rispondono da qui.
CREATE TABLE clicks (
    click_id    uuid        NOT NULL, -- uuidv7: the timestamp is inside
    created_at  timestamptz NOT NULL,
    account_id  uuid        NOT NULL,
    product_id  text        NOT NULL, -- shop-it-1005001234567
    country     char(2)     NOT NULL,
    gclid       text,
    PRIMARY KEY (created_at, click_id)
) PARTITION BY RANGE (created_at);

CREATE INDEX ON clicks (product_id, created_at);
Il catalogo è un’altra cosa, e ha un’altra forma: un database Postgres per nazione, con lo stesso schema, perché non esiste nessuna operazione che attraversi due nazioni e un giorno una nazione potrebbe spostarsi su un’altra macchina con un dump. Il primo del mese il generatore legge i file del marketplace, scrive il database della nazione e produce il feed, un TSV da qualche milione di righe che va a Google via SFTP. È un lavoro di ore, con la macchina al massimo, e non disturba nessuno: i click non passano più di qui.
Gli aggiornamenti continui, che prima tenevano il database sotto carico tutto il giorno, sono diventati un lavoro mirato. Un catalogo di milioni di prodotti invecchia, i prezzi cambiano, e Google scarta le offerte che non corrispondono più alla scheda; rinfrescare tutto, di continuo, era il modo in cui il sistema vecchio si teneva in regola, ed era il modo più caro. I prodotti che qualcuno ha cliccato sono già stati scelti dal traffico vero: un job notturno chiede al marketplace la scheda aggiornata dei prodotti cliccati il giorno prima e riscrive solo quelli. La tabella dei click, che è nata per contare i soldi, dice anche cosa vale la pena tenere fresco.
Il server non ha nessuna porta aperta verso internet. I consumer leggono le code, il deploy lo fa il cluster leggendo il repository, la dashboard sta dietro un proxy che accetta solo il traffico del CDN, e per entrare c’è una VPN. L’unico indirizzo pubblico che gli resta è quello da cui Google legge le conversioni, e se è irraggiungibile per un’ora Google ripassa.
Come si è passati
Il percorso critico nuovo è stato acceso prima di tutto il resto, perché non aspettava niente: due indirizzi, due code, nessun consumer. Per due settimane ha ricevuto i click in parallelo al sistema vecchio, con i messaggi accumulati nella coda e letti da un consumer di prova, confrontando i conteggi giorno per giorno. Poi i feed sono stati rigenerati con i nuovi identificativi e il nuovo link, una nazione alla volta, e il marketplace ha cambiato l’indirizzo delle notifiche. Gli ordini dei click vecchi hanno continuato ad arrivare per settimane, perché la coda fra click e acquisto è lunga, e li ha agganciati il sistema nuovo, a cui erano stati travasati i click del vecchio. L’infrastruttura cloud è stata spenta quando per trenta giorni di fila non aveva più agganciato nulla.
Concludo
Cloud o server dedicato, quindi? Tutti e due, ma non per le stesse cose. Il principio si dice in una riga: tenere sempre online solo ciò che non si può rifare, e tenerlo così piccolo da non avere nulla da cui dipendere. Quella parte sta in cloud, su un servizio gestito, e costa quasi niente proprio perché è piccola. Il percorso critico di questo sistema sono due indirizzi che non leggono un database, e il motivo per cui possono non leggerlo è un identificativo progettato per contenere ciò che serve. Tutto il resto, i milioni di righe, gli aggiornamenti, i feed, le statistiche, gira su una macchina a prezzo fisso che ha il permesso di spegnersi: un giorno di server fermo è un giorno di ritardo nelle statistiche, non un click pagato a vuoto né un ordine perso.
Il risultato, in numeri che chiunque può leggere: un sistema che prima costava mille euro al mese oggi ne costa cento, tutto compreso. Il server dedicato è più potente di quello che quei mille euro compravano, e non è mai sotto carico: i click non lo toccano, gli aggiornamenti sono mirati, e il primo del mese, con la macchina al massimo per ore, è un giorno come gli altri perché nessuno aspetta la sua risposta. Il tier sempre acceso risponde in pochi millisecondi anche quando il server è spento, e la bolletta non cresce più con le nazioni e con i prodotti: aggiungere una nazione è un database in più sulla stessa macchina, non una riga in più in fattura.
I limiti vanno detti. Il server è uno, e un guasto al disco vuol dire mezza giornata di ripristino dal backup: accettabile qui, perché nel frattempo il percorso critico accumula e nessun dato si perde. Gli identificativi composti sono un impegno: una sorgente non si rinomina più, e la forma degli URL del marketplace, se un giorno cambiasse, costringerebbe ad aggiornare il generatore, non gli identificativi già emessi. E se un giorno il marketplace smettesse di rimandare il nostro parametro nella notifica, il legame fra click e ordine si romperebbe senza che nessun server sia caduto: è il pezzo del percorso critico che non controlliamo, e si sorveglia con una metrica sola, la percentuale di ordini senza click.
Gli strumenti, per chi vuole i nomi.
Un container Go su Cloud Run, con due domini mappati; Lambda dietro API Gateway se usate AWS. Un host per i click e uno per gli ordini: il secondo sta nella configurazione del marketplace e non deve cambiare mai.
Pub/Sub su Google Cloud, due topic e due sottoscrizioni a trentun giorni di conservazione, lette in pull dal server; SQS se usate AWS. Il grezzo sta nel messaggio, non in un bucket: un oggetto per evento costava più di tutto il resto.
Una macchina dedicata da Hetzner, linea AX: 64 GB di memoria, due NVMe in mirror, prezzo fisso intorno ai cento euro al mese. Provisioning con Ansible, accesso con WireGuard, nessuna porta aperta.
k3s a nodo singolo con Traefik: Deployment per consumer, API e dashboard, CronJob per feed e rinfresco notturno, deploy a pull dal repository.
Postgres sull'host, non nel cluster: un database per nazione per il catalogo, uno per le statistiche con i click partizionati per giorno, uno piccolo per account e credenziali, che si ripristina in fretta. Chiavi interne bigserial o uuidv7, mai UUID casuali.
pgBackRest verso uno storage a oggetti fuori dal server, con il ripristino provato ogni mese.
TSV compressi consegnati via SFTP al Merchant Center, un'origine dati per nazione; le conversioni lette da Google da un endpoint sul server, ogni ora le ultime due e ogni giorno le ultime ventiquattro.
GitHub con le Actions: test a ogni pull request, immagine su GHCR a ogni merge, Terraform per il tier serverless.
OpenTelemetry e Grafana Cloud, con due allarmi: l'età del messaggio più vecchio non letto sulle code, e la percentuale di ordini senza click.